1 người, 20 AI agent và 2.000 PR mỗi tháng: Mô hình Căn bếp Michelin của Lauren Tan
Từ việc biến thành 'con thoi chuyển lời' cho AI đến quản lý đội ngũ hơn 20 agent tự hành tạo 2.000 pull request mỗi tháng, Lauren Tan (cựu Meta, Netflix, Cursor) đã tái định nghĩa vai trò của kỹ sư phần mềm như một bếp trưởng Michelin điều hành hệ thống thay vì ngồi canh từng dòng code.
1 Ẩn dụ "Căn bếp Michelin" thay vì dây chuyền nhà máy
Trong cộng đồng kỹ thuật, nhiều người thường so sánh việc ứng dụng trí tuệ nhân tạo (AI) với một dây chuyền công nghiệp tự động: nơi các dòng mã được tuôn ra hàng loạt theo công thức định sẵn. Tuy nhiên, Lauren Tan kịch liệt phản đối lối tư duy cơ học này. Với kinh nghiệm từng làm Quản lý kỹ thuật (Engineering Manager) tại Netflix, tham gia nhóm nòng cốt phát triển React tại Meta, làm việc tại Cursor và hiện dẫn dắt sản phẩm Grok Bot tại xAI, cô chọn một hình ảnh biểu tượng khác: căn bếp của một nhà hàng đạt chuẩn Michelin.
Một người nấu ăn tại nhà có thể tự mình làm tất cả mọi khâu: từ đi chợ, nhặt rau, tẩm ướp, nấu trên bếp cho đến dọn dẹp bồn rửa bát. Đó là hình ảnh quen thuộc của một lập trình viên truyền thống đơn lẻ. Nhưng khi căn bếp Michelin đón thêm hàng chục phụ bếp tài năng (tương tự như các AI agent), cách vận hành buộc phải thay đổi hoàn toàn. Từng trạm nấu nướng phải có phân công rành mạch, công cụ sơ chế phải được chuẩn hóa sắc bén, và quy trình chế biến phải đạt độ tin cậy tuyệt đối.
Theo Lauren, điều hành nhiều tác nhân AI cũng đòi hỏi tư duy chuẩn mực của một bếp trưởng: thiết kế cấu trúc hệ thống (System Architecture), thiết lập hàng rào kỹ thuật, và chịu trách nhiệm cao nhất về độ an toàn và chất lượng của sản phẩm cuối cùng.
2 Vượt thoát khỏi cái bẫy "Người chuyển lời" và định nghĩa lại "Xong việc"
Bước ngoặt tư duy của Lauren bắt đầu từ một trải nghiệm bế tắc tại Cursor khi cô được giao bài toán tối ưu hóa hiệu năng ứng dụng. Trong những ngày đầu, quy trình diễn ra theo một chu kỳ luẩn quẩn: cô mở công cụ đo kiểm (DevTools Profiler), tự mình đọc các chỉ số thời gian thực thi, rồi gõ prompt mô tả lại số liệu đó cho AI nghe. AI phản hồi bằng một đoạn code sửa đổi, cô đưa vào dự án, biên dịch lại, chạy thử, quan sát kết quả rồi lại tiếp tục giải thích cho AI.
Cô nhận ra mình đã vô tình trở thành một "con thoi chuyển lời" (human relay) đầy mệt mỏi. Chừng nào con người còn phải làm trạm trung chuyển dữ liệu ở giữa vòng lặp phản hồi, việc mở rộng quy mô để xử lý nhiều bài toán song song là điều hoàn toàn bất khả thi.
3 Chuẩn hóa công cụ với pstack và nguyên lý "Thay đổi môi trường"
Khi các agent bắt đầu biết tự kiểm thử, một dạng lãng phí tài nguyên mới lại xuất hiện: mỗi lần nhận một nhiệm vụ mới, mô hình ngôn ngữ lớn (LLM) lại tự sinh ra một đoạn mã kịch bản ngắn (ad-hoc script) để tương tác với trình duyệt hoặc cơ sở dữ liệu, dùng xong một lần rồi vứt bỏ. Đến lượt tác nhân tiếp theo, nó lại viết một đoạn script khác với cấu trúc hoàn toàn khác và dễ gặp lỗi cú pháp.
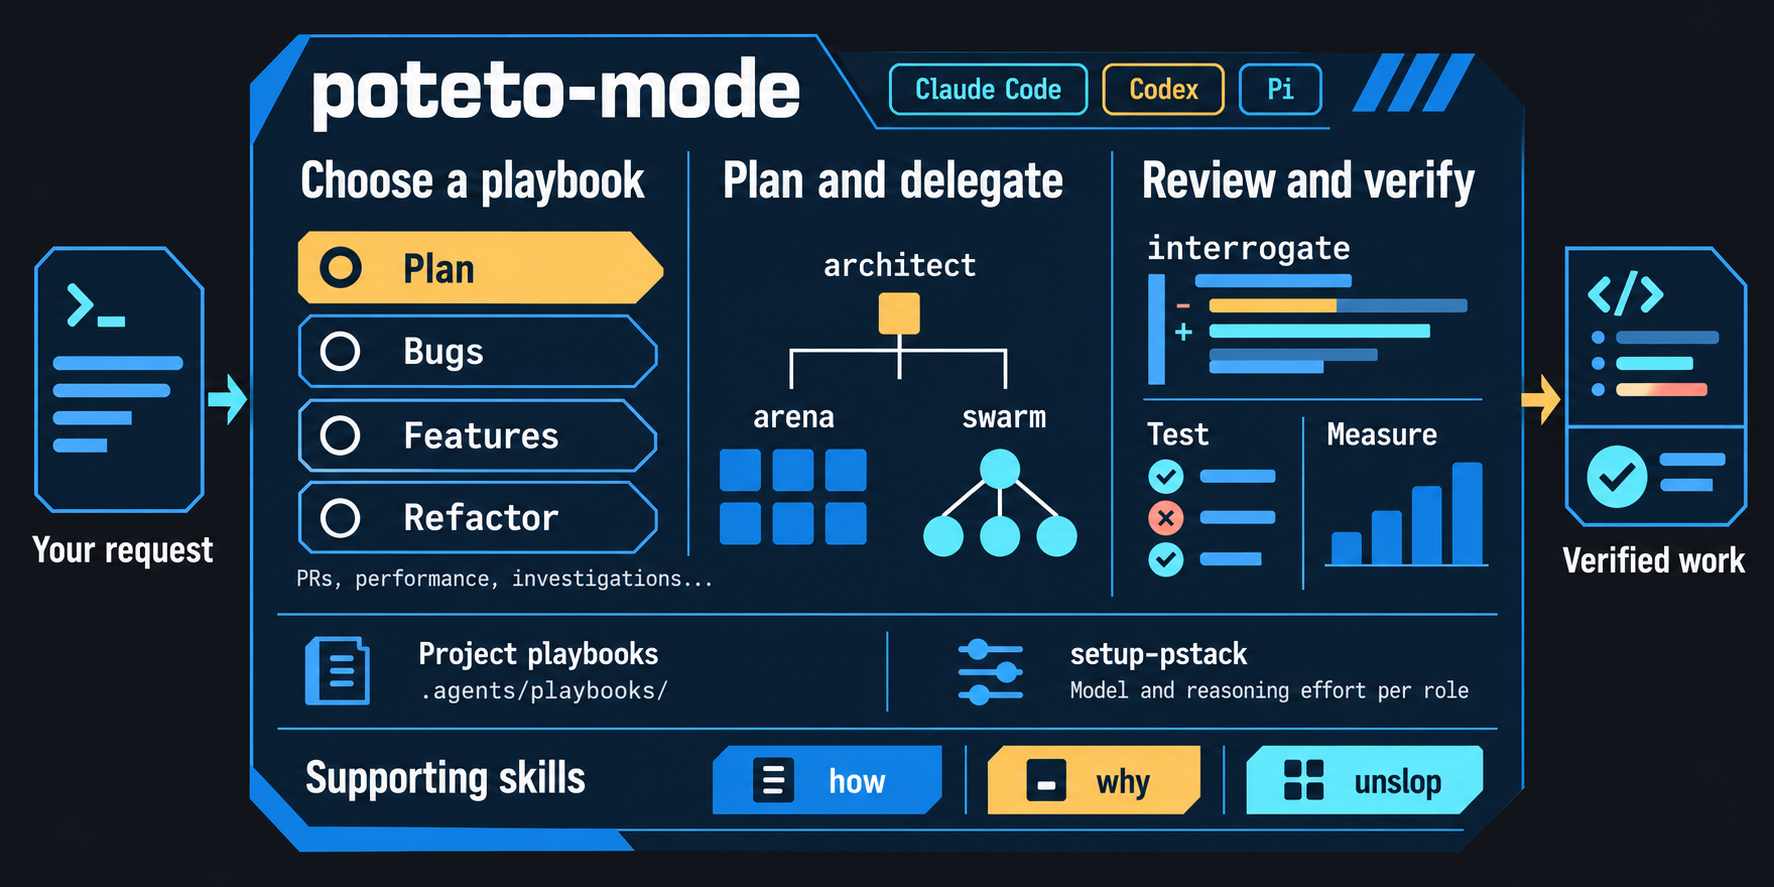
Nhận thấy sự lãng phí này, Lauren đã đóng gói toàn bộ các thao tác nền tảng lặp lại thành bộ công cụ mã nguồn mở pstack (hiện đã được cộng đồng mở rộng sang Claude Code, Codex và các hệ điều hành agent khác). Trong pstack, các quy trình cố định như phân tích nguyên nhân sự cố (investigation), tối ưu hiệu năng (perf-issue), kiểm tra tính tương đồng giao diện (visual-parity) hay theo dõi tích hợp liên tục (babysit) được chuẩn hóa thành các sổ tay hướng dẫn (playbooks) tường minh.
Bên cạnh công cụ, Lauren đặc biệt nhấn mạnh vai trò quyết định của cấu trúc mã nguồn (codebase architecture). Phiên bản đầu tiên của Grok Bot chỉ gồm khoảng 8 tệp mã nguồn khổng lồ, mỗi tệp dài hơn 10.000 dòng. AI luôn có xu hướng chọn "con đường ít kháng cự nhất": tiếp tục nhồi nhét thêm mã vào các tệp có sẵn thay vì bóc tách mô-đun mới. Lauren đã quyết liệt tái cấu trúc toàn bộ dự án theo hướng mô-đun hóa nghiêm ngặt (Feature-driven Modularity), thiết lập quy ước kiểm tra tĩnh khắt khe để triệt tiêu không gian phát sinh lỗi.
4 Mô hình hai vòng lặp và phương pháp gom cụm sự cố
Để vận hành đồng thời hơn 20 agent mà không bị quá tải thông tin, Lauren phân tách hệ sinh thái làm việc thành hai vòng lặp độc lập nhưng gắn kết chặt chẽ:
Vòng trong (Inner Loop): Là nơi các worker agent độc lập hoạt động trên từng nhánh làm việc cô lập (git worktree). Agent đọc hiểu mục tiêu kỹ thuật, chỉnh sửa mã nguồn, tự chạy bộ kiểm thử tự động, thu thập bằng chứng và đưa pull request về trạng thái hoàn chỉnh.
Vòng ngoài (Outer Loop): Là nơi tiếp nhận hàng trăm luồng thông tin hỗn loạn từ đời thực: báo cáo lỗi từ Slack, yêu cầu tính năng trên Linear, phản hồi người dùng trên mạng xã hội X hoặc thư điện tử. Lauren bố trí các agent đóng vai trò "chánh văn phòng" (Chief of Staff) chuyên nhiệm vụ phân loại, gom nhóm các triệu chứng giống nhau và chuẩn bị sẵn đầy đủ bối cảnh thực thi trước khi giao việc.
5 Giới hạn an toàn và phân tích đối chiếu đa chiều
Làm thế nào một kỹ sư duy nhất có thể kiểm soát hơn 2.000 PR mỗi tháng? Câu trả lời nằm ở phương pháp kiểm toán lấy mẫu ngẫu nhiên (Statistical Sampling Audit) sau khi code đã được merge qua hệ thống tích hợp liên tục (CI). Cô soi kỹ các mẫu code xấu, các lối tắt tạm bợ hoặc vi phạm kiến trúc; khi phát hiện lỗi lặp lại, cô can thiệp sửa đổi chính hệ thống sinh mã thay vì sửa cục bộ từng PR.
6 Bảng đối chiếu mô hình làm việc
| Tiêu chí so sánh | Lập trình viên sử dụng AI kiểu cũ | Kỹ sư trưởng Agentic (Mô hình Lauren Tan) |
|---|---|---|
| Vị trí con người | Đứng ở giữa làm "con thoi" chép code, đọc log, chuyển lời | Đứng ở ngoài thiết kế môi trường, quy chuẩn và thẩm định hệ thống |
| Tiêu chuẩn hoàn thành (DoD) | Mã chạy được trên lý thuyết, unit test hiện màu xanh | Bằng chứng định lượng thực tế (video thao tác, thông số FPS, flamegraph) |
| Phản ứng khi AI mắc lỗi | Viết prompt dài hơn, mắng AI, nhắc nhở thủ công lặp đi lặp lại | Tái cấu trúc thư mục, siết chặt linter, bổ sung công cụ chuyên dụng |
| Chiến lược xử lý sự cố | Thấy bug nào giao AI sửa ngay bug đó (chắp vá cục bộ) | Gom cụm triệu chứng vào tài liệu sống, xử lý tận gốc rễ vấn đề |
| Quy mô vận hành | Một cửa sổ chat tuần tự, dễ bị nghẽn cổ chai | Hơn 20 agent chạy song song trên các git worktree độc lập |
| Phê duyệt mã nguồn | Đọc từng dòng code trước khi merge (dễ kiệt sức và sót lỗi) | Kiểm toán lấy mẫu ngẫu nhiên hậu kỳ kết hợp hàng rào CI tự động |
Đúc kết
Con số 2.000 PR mỗi tháng không đơn thuần là chỉ số về tốc độ gõ phím của AI, mà là minh chứng cho một bước tiến hóa tất yếu trong phương thức sản xuất phần mềm. Bằng việc chuyển dịch từ người viết mã chi tiết sang vai trò một "bếp trưởng Michelin" kiến tạo môi trường, chuẩn hóa công cụ và định nghĩa chuẩn mực nghiệm thu, các kỹ sư phần mềm sẽ làm chủ quy mô làm việc chưa từng có. AI có thể nấu hàng ngàn món ăn với tốc độ kinh ngạc, nhưng chính con người mới là người lựa chọn thực đơn và giữ gìn linh hồn của sản phẩm.